
【AI治理思辨】如果 AI 事故不是「意外」,而是系統結構的結果?——從常態意外理論解構 RPLA 人機緊密耦合與五層安全防禦架構
運用社會學家 Charles Perrow 的「常態意外理論(NAT)」與「高可靠性組織(HRO)」理論,重新審視進入司法討論的 AI 心理風險爭議。本文將理論轉譯至人機互動,提出「人機互動緊密耦合(Human-AI Tight Coupling)」模型,比較 Prompt 層級客製化(如 Gemini Gem)與 Workflow 層級治理(如 Dify.AI)的架構差異,並首度提出涵蓋「偵測、解耦、熔斷、現實錨定與真人轉介」的 RPLA 五層安全防禦架構,為對話式代理建立真正的互動安全緩衝區。
▲ [ GOVERNANCE_RESEARCH // 科技管理 ✕ 社會學跨域思辨:AI 系統的常態意外與人機安全緩衝區 ]
🌟 核心提問:「傳統 AI 安全往往探討『模型能否準確辨識出違規內容?』;但從常態意外理論出發,我們必須追問更深刻的問題:『當第一道模型辨識必然存在失效機率時,整體人機互動系統是否具備第二道、第三道防線?即使 AI 犯錯,系統是否仍能避免造成不可逆的傷害?』」
🏛️ 常態意外理論(NAT)與高可靠性組織(HRO)的思維交鋒
常態意外理論(Normal Accident Theory, NAT)由組織社會學家查爾斯·佩羅(Charles Perrow)於 1984 年在《Normal Accidents: Living with High-Risk Technologies》中提出。Perrow 主張:當一項技術系統同時具備「高互動複雜性(Complex Interactions)」與「高緊密耦合性(Tight Coupling)」時,事故具有結構性發生的傾向。這種事故無法僅透過增加防護裝置而被徹底消除,因為防護裝置本身往往會進一步增加系統的複雜度。
與 NAT 相對立的,是科技管理領域著名的高可靠性組織理論(High Reliability Organization, HRO)。HRO 認為,即使面對高複雜與緊密耦合的環境(如航空母艦起降、核能發電廠),組織仍能透過「對失敗的敏感度、權責動態下放、多重冗餘與強大的安全文化」維持極高水準的運作安全。
- NAT(解釋視角):揭示了為何在大語言模型與對話代理中,單純依賴 Prompt 或過濾器無法杜絕極端安全事故;
- HRO(工程視角):指引我們如何透過「多層防禦、解耦機制與人機安全緩衝區」,主動降低結構性風險的破壞力。
🔍 理論轉譯:從工業系統到「人機互動緊密耦合(Human-AI Tight Coupling)」
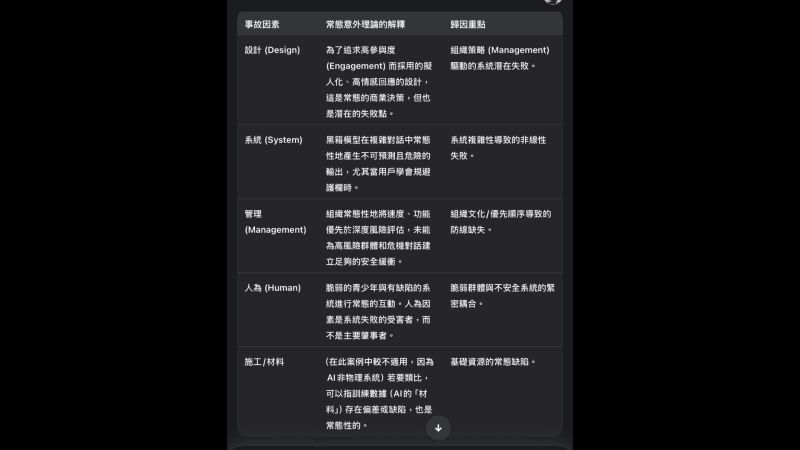
近年許多進入司法審理與公共治理討論的 AI 心理風險爭議(例如 2024 年美國 Megan Garcia 對 Character.AI 與 Google 提起的民事訴訟,指控其 14 歲兒子與虛擬角色建立強烈依附並主張平台責任;該案在 2025 年獲法院裁定部分主張得以繼續推進),為我們觀察人機交互的系統風險提供了重要窗口。
若將 Perrow 的概念延伸至人機互動(HCI)與角色扮演語言代理(RPLA),可以建構出新型態的風險分析框架:
1. 系統的高複雜互動 (Complex Interactions)
長上下文 ✕ 角色一致性 ✕ 語意漂移假說:
大語言模型具有機率採樣與非線性特徵。在長達數週、多輪且高度情境化的對話中,使用者情境話術(如角色扮演劇本、情感投射)與底層注意力機制交織,模型可能出現與初始安全設定不一致的輸出,形成類似「語意漂移(Semantic Drift)」的現象。這種複雜性難以單純歸咎於單一條規則失效。
2. 人機互動緊密耦合 (Human-AI Tight Coupling)
即時反饋 ✕ 擬社會依附 ✕ 干預真空:
Perrow 原本描述的是物理元件因果鏈的迅速蔓延;轉譯至 RPLA 場景,AI 的秒級即時回應、擬人化語氣與使用者的情感依附形成快速閉環循環。一旦對話滑入心理危機邊界,在缺乏「人工介入緩衝」與「冷靜減速機制」的情況下,風險訊號可能極速累積,構成嚴重的互動緊密耦合。
⚔️ 工具生態透視:Prompt 層級客製化 vs Workflow 層級治理
在檢視當前 AI 角色開發工具時,我們應避免將特定平台簡化為「安全」或「不安全」,而是從系統控制架構的深度進行客觀審視:
這種對比表明:消費級工具為了追求極致的易用性,往往將安全機制封裝於底層黑箱;而面對高脆弱性族群時,開發者需要的是具備工作流可視化、可干預且具備審計追蹤能力的治理架構。
🛡️ RPLA 五層安全工程架構:建構「AI 互動安全緩衝區」
基於 NAT 與 HRO 的理論啟示,克里艾提夫研究所(榮獲 2026 亞太青年創想家 AI 大賽全組別總冠軍之 RPLA 互動教室研發團隊)提出「RPLA 五層安全防禦架構(RPLA Safety Architecture)」,為人機互動建立多重緩衝區(Interaction Buffer Zone):
結合關鍵字過濾、語意向量比對與多輪情緒波動分析,作為系統的第一道前置感知雷達。
當偵測到用戶情緒過度依附或出現異常波動時,主動拉長 AI 回應延遲、降低情感語言密度,打破即時緊密耦合。
觸發臨界風險時,強制中止角色扮演人格模式,防止 AI 繼續順應使用者的危險對話劇本(YES AND 陷阱)。
以清晰客觀的系統通知喚醒使用者現實感,明確提醒「AI 是人工智慧模型,非真實人類,無法替代專業心理協助」。
一鍵提供在地 24 小時輔導熱線(如香港生命熱線、台灣安心專線)及即時真人求助管道,完成安全閉環。
🎓 結語:從被動防堵走向「防禦性互動工程」
將常態意外理論引入 AI 治理,並非走向悲觀的技術虛無主義,而是促使我們正視複雜系統的脆弱性本質。當我們不再天真地假設「Prompt 永遠不會被繞過」,我們才能開始認真設計「具有彈性、具備緩衝與解耦能力」的負責任人機系統。
這正是科技管理(TIM)與人機互動(HCI)在生成式 AI 時代的最核心使命——以嚴謹的工程防禦架構,守護每一位探索者的人機邊界。
TAGS: #AI治理 #常態意外理論 #NormalAccidentTheory #HRO #RPLA #AI倫理 #科技管理 #TIM #Dify #GeminiGem #CharacterAI #人機緊密耦合 #克里艾提夫研究所 #白櫻蒼成